Khi doanh nghiệp thử hỏi ChatGPT hay Claude về quy trình nội bộ, chính sách bảo hành hay điều khoản trong một hợp đồng cụ thể, câu trả lời thường nghe hợp lý nhưng sai, vì mô hình chưa bao giờ đọc tài liệu của doanh nghiệp. RAG là cách phổ biến nhất hiện nay để giải quyết chuyện đó mà không phải huấn luyện một mô hình riêng.
RAG là gì
Retrieval Augmented Generation (RAG) là một kỹ thuật trong trí tuệ nhân tạo (AI) kết hợp truy xuất thông tin từ cơ sở dữ liệu với sức mạnh của các mô hình ngôn ngữ lớn (LLM) để tạo ra câu trả lời chính xác và phù hợp với ngữ cảnh. Tên gọi nói đúng ba bước: Retrieval là truy xuất, tìm tài liệu liên quan; Augmented là tăng cường, bổ sung tài liệu đó vào câu hỏi; Generation là tạo sinh, để mô hình viết câu trả lời.
Có thể hình dung LLM như một nhân viên rất giỏi diễn đạt nhưng mới vào công ty ngày đầu. Hỏi họ về quy trình hoàn tiền thì họ sẽ đoán. Đưa cho họ đúng trang sổ tay quy trình rồi mới hỏi, họ trả lời chính xác và chỉ được chỗ đã đọc. RAG tự động hoá việc "đưa đúng trang sổ tay" cho mỗi câu hỏi.
Vì sao LLM cần RAG
- Kiến thức đóng băng: LLM chỉ biết những gì có trong dữ liệu huấn luyện, tới một thời điểm nhất định; quy định mới, bảng giá mới, sản phẩm mới nó không biết.
- Không biết tài liệu riêng: hợp đồng, quy trình, hồ sơ khách hàng của doanh nghiệp không nằm trong dữ liệu huấn luyện.
- Bịa câu trả lời: khi không biết, LLM vẫn có thể viết ra một câu nghe hợp lý. RAG buộc câu trả lời dựa trên đoạn tài liệu cụ thể và cho người dùng kiểm lại nguồn.
- Cập nhật rẻ: tài liệu đổi thì chỉ cần cập nhật kho tài liệu, không phải huấn luyện lại mô hình.
RAG hoạt động như thế nào
Một hệ thống RAG có hai giai đoạn: chuẩn bị dữ liệu (làm một lần và cập nhật khi tài liệu đổi) và trả lời câu hỏi (chạy mỗi lần người dùng hỏi).
Giai đoạn 1: chuẩn bị dữ liệu
- Thu thập tài liệu: quy trình, chính sách, hợp đồng, câu hỏi thường gặp, hướng dẫn sử dụng, từ Google Drive, SharePoint, phần mềm nội bộ hoặc website.
- Làm sạch và chuyển thành văn bản: đọc PDF, tệp Word, bảng; tài liệu scan cần nhận dạng chữ (OCR).
- Chia đoạn (chunking): cắt tài liệu thành các đoạn vừa đủ một ý, giữ tiêu đề mục để đoạn không mất ngữ cảnh.
- Tạo embedding: dùng mô hình embedding biến mỗi đoạn thành một vector, một dãy số biểu diễn ý nghĩa của đoạn văn.
- Lưu trong cơ sở dữ liệu vector và chỉ mục từ khoá, kèm thông tin phụ như nguồn, ngày cập nhật, ai được xem.
Giai đoạn 2: trả lời câu hỏi
- Người dùng hỏi, ví dụ: "Quy trình hoàn tiền cho khách VIP thế nào?"
- Câu hỏi (truy vấn) được biến thành vector bằng cùng mô hình embedding.
- Hệ thống sẽ truy xuất thông tin liên quan từ cơ sở dữ liệu: tìm các đoạn có ý nghĩa tương tự câu hỏi, thường kết hợp thêm tìm theo từ khoá.
- Xếp hạng lại các đoạn tìm được, giữ vài đoạn liên quan nhất, lọc theo quyền của người hỏi.
- Ghép các đoạn đó cùng câu hỏi thành câu lệnh gửi LLM, kèm chỉ dẫn chỉ trả lời dựa trên tài liệu đã cho.
- LLM đưa ra câu trả lời kèm trích dẫn, liên kết tới tài liệu gốc để người dùng kiểm lại.
Embedding và cơ sở dữ liệu vector
Embedding là cách biểu diễn văn bản thành vector sao cho hai đoạn có ý nghĩa gần nhau thì vector cũng gần nhau, dù dùng từ khác nhau. Nhờ vậy câu hỏi "khách đổi ý muốn trả hàng" vẫn tìm được đoạn quy trình có tiêu đề "chính sách hoàn tiền". Cơ sở dữ liệu vector là nơi lưu các vector này và tìm nhanh những vector gần nhất; có thể là dịch vụ chuyên dụng hoặc chính PostgreSQL với tiện ích pgvector, đủ cho phần lớn kho tài liệu của doanh nghiệp vừa và nhỏ.
Tìm theo ý nghĩa có điểm yếu với mã sản phẩm, số hợp đồng, tên riêng. Vì vậy hệ thống RAG tốt thường kết hợp cả tìm theo ý nghĩa và tìm theo từ khoá (hybrid search).
RAG, fine-tuning hay đưa cả tài liệu vào câu lệnh
| Tiêu chí | RAG | Fine-tuning | Đưa cả tài liệu vào câu lệnh |
|---|---|---|---|
| Cách làm | Tìm đoạn liên quan rồi đưa vào câu lệnh | Huấn luyện thêm mô hình trên dữ liệu riêng | Dán toàn bộ tài liệu vào mỗi câu hỏi |
| Hợp với | Kho tài liệu lớn, thay đổi thường xuyên | Dạy văn phong, định dạng, tác vụ lặp lại | Vài tài liệu ngắn, dùng thử nhanh |
| Cập nhật kiến thức | Cập nhật kho, dùng ngay | Phải huấn luyện lại | Sửa tài liệu là xong |
| Trích dẫn nguồn | Có, tự nhiên | Khó | Có thể |
| Chi phí mỗi câu hỏi | Vừa phải, chỉ gửi vài đoạn | Thấp khi đã huấn luyện | Cao khi tài liệu dài |
| Rủi ro bịa | Giảm, kiểm được qua trích dẫn | Vẫn còn | Giảm, nhưng dễ lạc khi tài liệu quá dài |
Với nhu cầu "trả lời dựa trên tài liệu của công ty", RAG thường là lựa chọn đầu tiên. Fine-tuning hợp hơn khi cần mô hình viết theo một khuôn cố định hoặc phân loại theo nhãn riêng, và có thể kết hợp với RAG.
Ví dụ ứng dụng RAG trong doanh nghiệp
1. Trợ lý tra cứu nội bộ
Nhân viên hỏi: "Quy trình tiếp nhận khách hàng mới gồm những bước nào?". Trợ lý trả lời dựa trên sổ tay quy trình, kèm đường dẫn tới đúng mục. Bộ phận nhân sự, hành chính, IT bớt phải trả lời lặp lại cùng một câu hỏi.
2. Chăm sóc khách hàng
Khách hỏi: "Ứng dụng không đăng nhập được, đặt lại mật khẩu thế nào?". Trợ lý trả lời dựa trên câu hỏi thường gặp và tài liệu hướng dẫn; câu hỏi ngoài tài liệu được chuyển cho nhân viên thay vì để mô hình tự đoán.
3. Hỏi đáp hợp đồng, pháp lý
Hỏi: "Điều khoản 4.2 hợp đồng X quy định gì về phạt chậm tiến độ?". Hệ thống tìm đúng đoạn trong hợp đồng và trích nguyên văn, người phụ trách pháp lý đọc lại nguồn trước khi dùng.
4. Hỗ trợ bán hàng
Nhân viên kinh doanh hỏi về thông số sản phẩm, chính sách chiết khấu, cách trả lời các phản đối thường gặp; trợ lý tra trong tài liệu sản phẩm và tài liệu bán hàng.
5. Tra cứu quy định
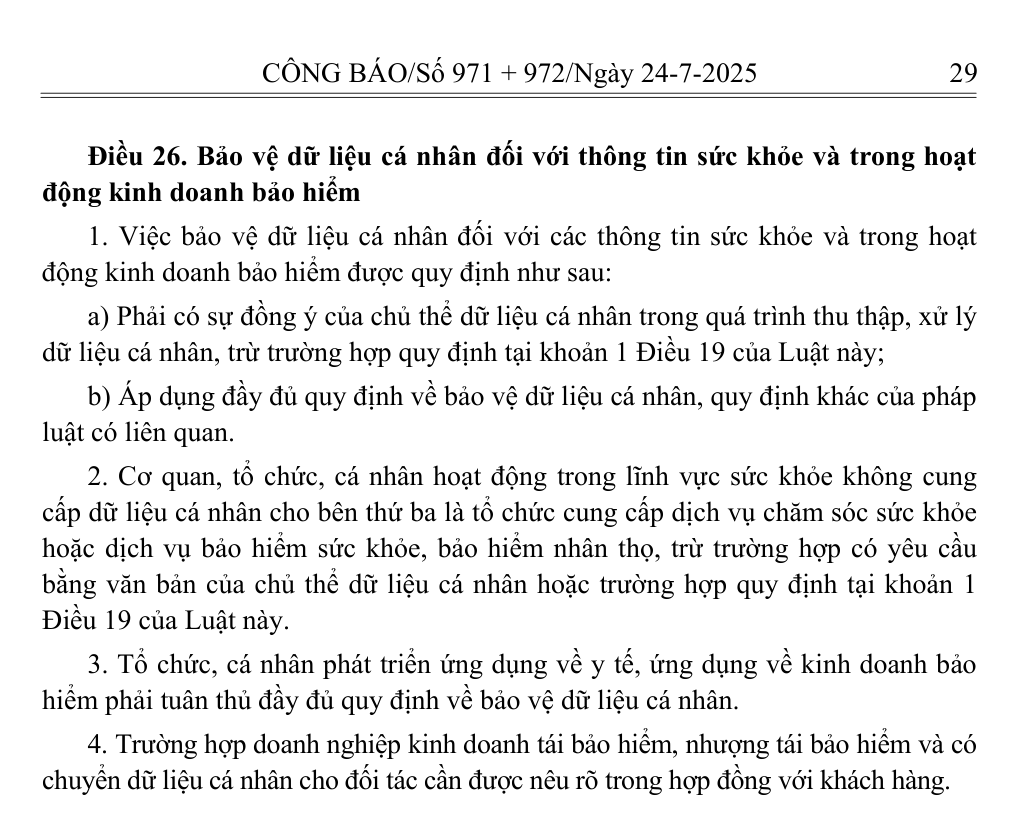
Hỏi: "Luật Bảo vệ dữ liệu cá nhân yêu cầu gì với dữ liệu sức khoẻ?". Hệ thống tìm trong văn bản pháp luật và chính sách nội bộ đã nạp, trả lời kèm điều khoản gốc.
Thành phần kỹ thuật
- Mô hình ngôn ngữ lớn: qua API của OpenAI, Anthropic, Google, hoặc mô hình mở tự chạy trên máy chủ riêng.
- Mô hình embedding: của nhà cung cấp API hoặc mô hình mở hỗ trợ tốt tiếng Việt.
- Cơ sở dữ liệu vector: PostgreSQL với pgvector, hoặc dịch vụ chuyên dụng khi dữ liệu rất lớn.
- Khung điều phối: LangChain, LlamaIndex, hoặc mã tự viết cho luồng đơn giản.
- Giao diện: khung trò chuyện trên web, trong phần mềm nội bộ, hoặc qua Zalo OA.
Giá API của các mô hình thay đổi thường xuyên; công cụ so sánh giá API LLM trên ALODEV Lab giúp ước tính chi phí theo số câu hỏi. Đội kỹ thuật muốn tự dựng bản thử có thể đọc hướng dẫn xây hệ thống hỏi đáp RAG trên dữ liệu riêng, viết cho lập trình viên trên blog của founder ALODEV.
Chất lượng RAG phụ thuộc vào chất lượng dữ liệu
- Tài liệu mâu thuẫn hoặc lỗi thời cho ra câu trả lời mâu thuẫn. Dọn kho tài liệu trước, đánh dấu bản nào là bản hiện hành.
- Chia đoạn hợp lý: đoạn quá nhỏ mất ngữ cảnh, quá lớn thì lẫn nhiều ý và tốn chi phí.
- Xếp hạng lại (re-ranking): lấy nhiều đoạn ứng viên rồi chọn lại vài đoạn liên quan nhất.
- Tìm kết hợp ý nghĩa và từ khoá cho mã hàng, số hiệu, tên riêng.
- Trích dẫn nguồn trong mọi câu trả lời để người dùng kiểm lại.
- Nút đánh giá đúng/sai để thu thập câu trả lời kém và sửa dần.
Đánh giá một hệ thống RAG
Không đo thì không biết trợ lý đang trả lời đúng bao nhiêu. Trước khi đưa cho người dùng, chuẩn bị một bộ câu hỏi kiểm thử lấy từ câu hỏi thật, mỗi câu có đáp án và tài liệu nguồn đúng, rồi đo:
| Chỉ số | Đo gì |
|---|---|
| Truy xuất đúng | Tài liệu nguồn đúng có nằm trong các đoạn tìm được không |
| Câu trả lời đúng | Nội dung trả lời khớp đáp án, do người phụ trách nghiệp vụ chấm |
| Bám nguồn | Câu trả lời chỉ dùng thông tin có trong các đoạn đã đưa, không thêm thắt |
| Biết từ chối | Câu hỏi ngoài tài liệu được trả lời là không có thông tin |
| Thời gian và chi phí | Thời gian phản hồi và chi phí API trung bình mỗi câu hỏi |
Chạy lại bộ kiểm thử mỗi khi đổi cách chia đoạn, đổi mô hình hay nạp thêm tài liệu, để biết thay đổi làm tốt lên hay kém đi.
Bảo mật và phân quyền
- Lọc theo quyền trước khi đưa vào câu lệnh: nhân viên chỉ nhận câu trả lời từ tài liệu họ được phép đọc.
- Dữ liệu gửi tới API của nhà cung cấp mô hình: đọc điều khoản về lưu trữ và dùng dữ liệu; với dữ liệu nhạy cảm cân nhắc tự chạy mô hình mở trên máy chủ riêng.
- Ghi nhật ký câu hỏi và câu trả lời để kiểm tra khi có sự cố, tuân thủ quy định về dữ liệu cá nhân.
- Chống chèn lệnh: tài liệu nạp vào có thể chứa câu lệnh độc hại; hệ thống phải coi nội dung tài liệu là dữ liệu, không phải chỉ thị.
Chi phí triển khai RAG gồm những gì
- Công dựng: thu thập và làm sạch tài liệu, đường ống chia đoạn và cập nhật, giao diện, phân quyền, bộ kiểm thử.
- Chi phí API mô hình: tính theo lượng token của câu hỏi, các đoạn tài liệu đưa vào và câu trả lời.
- Chi phí embedding: khi nạp tài liệu lần đầu và khi tài liệu thay đổi.
- Hạ tầng: cơ sở dữ liệu vector, máy chủ ứng dụng; máy chủ có GPU nếu tự chạy mô hình.
- Vận hành: người phụ trách cập nhật tài liệu và xem lại các câu trả lời bị đánh giá sai.
Phần lớn chi phí dài hạn không nằm ở API mà ở việc giữ kho tài liệu đúng và mới. Một trợ lý RAG trên kho tài liệu không ai cập nhật sẽ trả lời sai một cách tự tin sau vài tháng.
Sai lầm phổ biến
- Chia đoạn không hợp lý: quá nhỏ mất ngữ cảnh, quá lớn lãng phí token và lẫn ý.
- Không cập nhật kho khi tài liệu thay đổi: trợ lý trả lời theo thông tin cũ.
- Không có bộ câu hỏi kiểm thử: không biết độ chính xác thật.
- Không trích dẫn nguồn: người dùng không tin câu trả lời, hoặc tin nhầm câu sai.
- Nạp mọi tài liệu cho mọi người: lộ tài liệu cho người không có quyền.
Câu hỏi thường gặp
RAG là gì nói ngắn gọn?
RAG là cách cho mô hình ngôn ngữ lớn tìm và đọc tài liệu liên quan trước khi trả lời, để câu trả lời dựa trên dữ liệu của doanh nghiệp và có trích dẫn nguồn.
RAG có cần huấn luyện lại mô hình không?
Không. RAG dùng mô hình có sẵn; kiến thức riêng nằm trong kho tài liệu và được đưa vào từng câu hỏi. Cập nhật tài liệu là trợ lý dùng được ngay.
RAG có trả lời tiếng Việt tốt không?
Được, nếu chọn mô hình embedding và mô hình ngôn ngữ hỗ trợ tốt tiếng Việt và kiểm bằng bộ câu hỏi tiếng Việt thật. Tài liệu scan chất lượng kém là nguyên nhân sai phổ biến hơn là ngôn ngữ.
RAG có hết bịa không?
Giảm đáng kể nhưng không hết. Vì vậy câu trả lời cần kèm trích dẫn, hệ thống cần được dặn trả lời "không có thông tin" khi tài liệu không nói tới, và cần bộ kiểm thử để đo.
Doanh nghiệp muốn dựng trợ lý tra cứu trên tài liệu nội bộ có thể xem dịch vụ AI agent và chatbot của ALODEV hoặc liên hệ. Buổi khảo sát đầu không tính phí.