Khi nào cần tự host
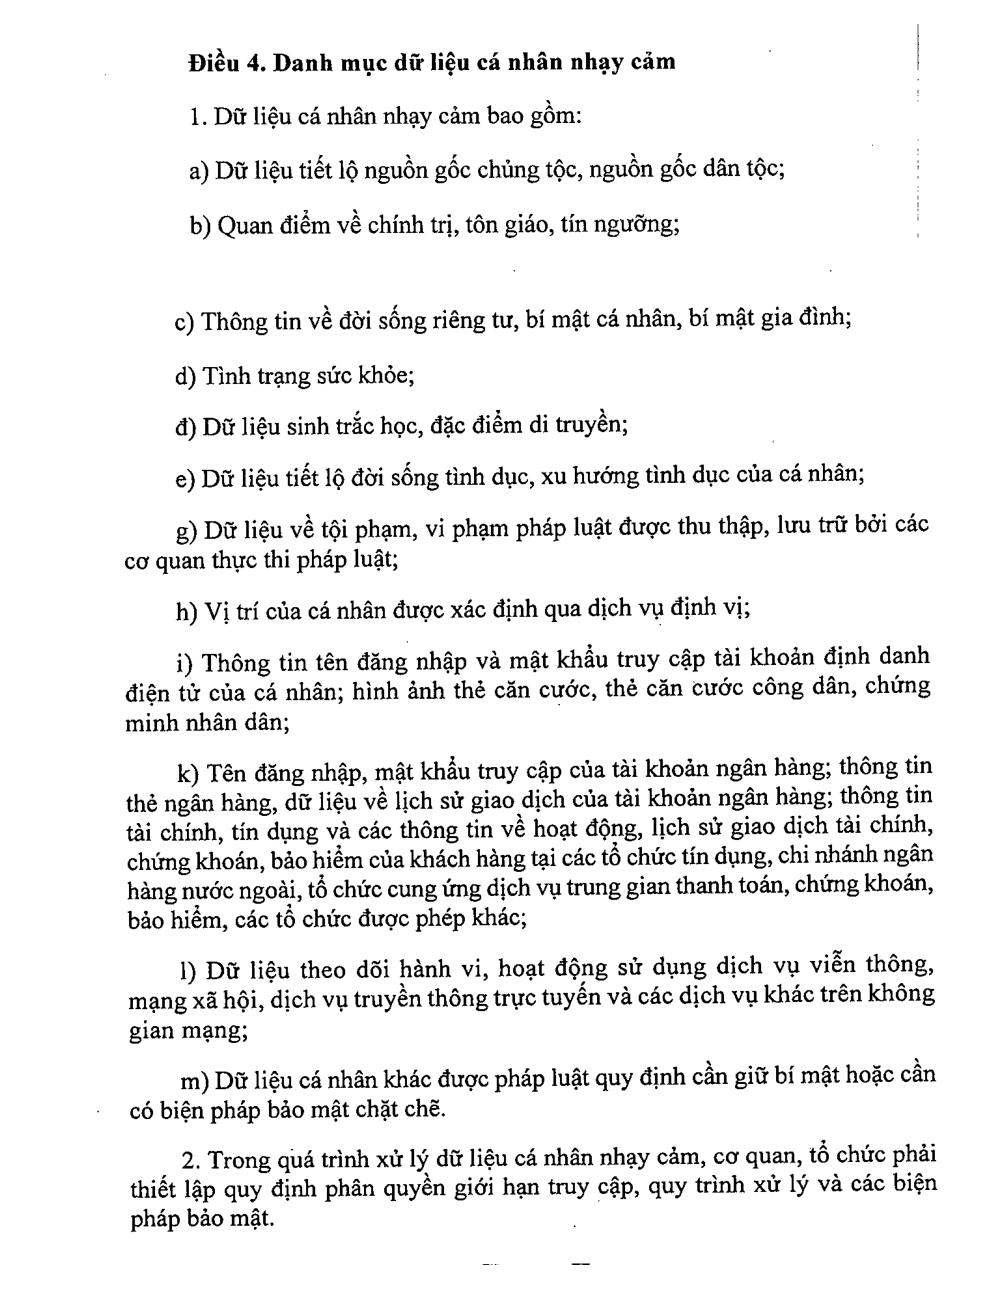
- Data y tế VN là dữ liệu cá nhân nhạy cảm (Nghị định 356/2025), gửi cloud nước ngoài phải lập hồ sơ chuyển dữ liệu xuyên biên giới.
- Data tài chính banking - regulator yêu cầu data tại VN.
- Hợp đồng pháp lý confidential - không gửi ra ngoài.
- Data IP độc quyền - không leak qua training.
- Volume cao (> 10M token/ngày) - cost OpenAI lên $300-1000/ngày.
Top model open-source 2026
- Llama 3.3 70B (Meta): tốt cho general task. Tiếng Việt khá.
- Qwen 2.5 72B (Alibaba): mạnh tiếng Á, đặc biệt Trung + Việt.
- Mistral Large 2 (Mistral AI): efficient, performance/cost tốt.
- DeepSeek V3: hot 2025, cost-effective.
Performance: 80-90% GPT-4 cho most task. Coding + reasoning yếu hơn 5-10%.
Hardware requirement
- Llama 70B INT4 quantize: cần ~40GB VRAM → 1 GPU A100 80GB đủ.
- Llama 70B FP16: cần ~140GB → 2 GPU A100 80GB.
- Qwen 72B INT4: ~45GB → 1 A100 80GB.
- Inference speed: 30-80 token/sec với A100.
Cost analysis
Cloud GPU rental
- RunPod A100 80GB: $1.5-2.5/giờ = $1,000-1,800/tháng.
- Lambda Labs A100 80GB: $1.3/giờ = $930/tháng.
- Modal.com serverless: pay-per-use, tốt khi traffic không 24/7.
- VN cloud (CMC, Viettel IDC): rare A100, ít competitive vs quốc tế.
On-premise
- 1x A100 80GB GPU: $20-30k.
- Server (CPU + RAM + SSD): $5-10k.
- Networking + cooling: $5k.
- Total: $30-45k. Useful life 3-5 năm.
- Cost/tháng: $700-1,000 amortized + electric + maintenance.
Tools để deploy
- vLLM: serving framework, throughput cao.
- Text Generation Inference (Hugging Face): production-ready.
- Ollama: local development simple.
- LM Studio: GUI cho non-tech.
Muốn thử trước khi đầu tư máy chủ GPU, một VPS chạy Ollama đủ để đánh giá Llama và Qwen với dữ liệu tiếng Việt; các bước cài có trong bài tự host LLM bằng Ollama trên VPS ở trancongthang.vn.
Performance comparison
Cùng 1M token request:
- OpenAI GPT-4o: $2.5-10 (input/output).
- Self-host Llama 70B trên A100: amortized cost ~$1-2 (cloud) hoặc $0.5-1 (on-premise).
- Break-even: ~10M token/ngày on-premise, 30M token/ngày cloud rental.
Khi nào KHÔNG nên tự host
- Volume < 1M token/ngày - OpenAI rẻ hơn.
- Không có DevOps experience - maintain LLM stack phức tạp.
- Cần latest model features (vision, function calling sophisticated) - open-source lag 6-12 tháng so frontier.
- Cần multilingual mạnh + bao gồm tiếng Anh hoàn hảo - GPT-4/Claude vẫn lead.
Doanh nghiệp data nhạy cảm cần tự host LLM? Alodev cung cấp setup + deployment 80-200tr. /lien-he