Bỏ qua menu, vào nội dung chính

LLM là gì và cách tích hợp mô hình ngôn ngữ lớn cho doanh nghiệp

Mô hình ngôn ngữ lớn như GPT, Claude, Gemini có thể đọc, tóm tắt, phân loại và trả lời dựa trên văn bản, hình ảnh. ALODEV tích hợp các mô hình này vào phần mềm doanh nghiệp cho những việc cụ thể, có người kiểm tra kết quả ở các bước quan trọng.

Dùng cho

  • Tra cứu tài liệu nội bộ

    Nhân viên hỏi về quy trình, chính sách, sản phẩm và nhận câu trả lời kèm trích dẫn nguồn từ tài liệu của doanh nghiệp.

  • Đọc hoá đơn, chứng từ

    Trích xuất mã số thuế, số tiền, thuế suất từ ảnh hoặc tệp PDF, để kế toán kiểm tra trước khi nhập sổ.

  • Phân loại email, tin nhắn

    Gắn nhãn yêu cầu đến theo loại như khách mới, hỗ trợ, hợp đồng và gợi ý bản trả lời để nhân viên duyệt.

  • Biên bản cuộc họp

    Chuyển ghi âm thành văn bản, tóm tắt nội dung và danh sách việc cần làm.

  • Gợi ý báo giá

    Đề xuất hạng mục dựa trên yêu cầu khách hàng và các báo giá trước đó, nhân viên kinh doanh chỉnh và duyệt.

LLM là gì

LLM là viết tắt của Large Language Model, tiếng Việt là mô hình ngôn ngữ lớn. Đây là loại mô hình trí tuệ nhân tạo được huấn luyện trên lượng dữ liệu văn bản khổng lồ để hiểu và tạo ra ngôn ngữ tự nhiên: trả lời các câu hỏi, viết, tóm tắt, dịch, phân loại, trích xuất thông tin. GPT của OpenAI, Claude của Anthropic, Gemini của Google, Llama của Meta, Qwen của Alibaba là những mô hình ngôn ngữ lớn phổ biến.

Chữ "lớn" chỉ hai thứ: lượng dữ liệu huấn luyện và số tham số của mô hình. Tham số là những con số bên trong mạng nơ ron được điều chỉnh trong quá trình huấn luyện; các mô hình hiện nay có từ vài tỷ tới hàng trăm tỷ tham số hoặc hơn. Nhờ quy mô đó, LLM nắm được ngữ pháp, kiến thức phổ thông và cả cách lập luận thường gặp trong văn bản.

LLM là một nhánh của xử lý ngôn ngữ tự nhiên (NLP). Trước LLM, mỗi việc như phân loại email, dịch, trích xuất tên riêng cần một mô hình riêng huấn luyện cho đúng việc đó. LLM làm được nhiều việc với cùng một mô hình, chỉ cần mô tả việc cần làm bằng lời trong câu lệnh (prompt).
Mô hình ngôn ngữ lớn hoạt động như thế nào

Dự đoán từ tiếp theo

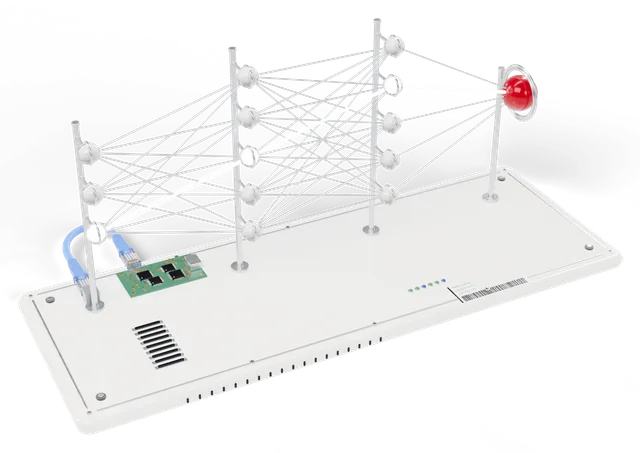
Ở mức cơ bản, LLM làm một việc: dựa trên đoạn văn bản đã có, dự đoán từ tiếp theo (chính xác hơn là token, một mảnh từ). Nó chọn token tiếp theo, nối vào, rồi lại dự đoán token sau đó, cứ thế cho tới khi hết câu trả lời. Việc tưởng đơn giản này, khi mô hình đủ lớn và được huấn luyện trên đủ nhiều văn bản, cho ra khả năng viết mạch lạc và trả lời phù hợp với ngữ cảnh.

Kiến trúc Transformer

Các LLM hiện nay dựa trên kiến trúc mạng nơ ron Transformer, công bố năm 2017. Thành phần chính của mô hình là cơ chế chú ý (attention), cho phép mô hình xét mối quan hệ giữa các từ ở bất kỳ vị trí nào trong đoạn văn cùng lúc. So với các mô hình trước như mạng nơ ron hồi quy (RNN) đọc văn bản lần lượt từng từ và dễ quên phần đầu của đoạn dài, Transformer xử lý song song và giữ ngữ cảnh dài tốt hơn, nên huấn luyện được ở quy mô rất lớn.

Ba giai đoạn huấn luyện

  1. Tiền huấn luyện: mô hình đọc lượng dữ liệu khổng lồ từ sách, trang web, mã nguồn, học cách dự đoán token tiếp theo. Giai đoạn này tạo ra kiến thức và khả năng ngôn ngữ nền.
  2. Tinh chỉnh theo chỉ dẫn: mô hình được huấn luyện thêm trên các cặp câu hỏi và câu trả lời mẫu để biết làm theo yêu cầu thay vì chỉ viết tiếp văn bản.
  3. Tinh chỉnh theo phản hồi: con người hoặc hệ thống chấm điểm các câu trả lời, mô hình được điều chỉnh các tham số để ưu tiên câu trả lời hữu ích, trung thực, an toàn hơn.

Cửa sổ ngữ cảnh

Mỗi lần gọi, LLM chỉ "nhìn thấy" một lượng văn bản giới hạn gọi là cửa sổ ngữ cảnh, gồm câu lệnh, tài liệu đưa kèm và câu trả lời. Muốn LLM trả lời dựa trên tài liệu của doanh nghiệp, phải đưa đúng đoạn tài liệu vào cửa sổ này; đó là việc kỹ thuật RAG làm.

LLM làm được gì và không làm được gì

Điểm mạnh và giới hạn của mô hình ngôn ngữ lớn trong công việc doanh nghiệp
Làm tốtCần cẩn trọng
Tóm tắt, viết lại, dịch văn bảnCon số, ngày tháng, trích dẫn: có thể bịa nếu không có tài liệu nguồn
Trích xuất thông tin từ văn bản, hình ảnh chứng từTính toán nhiều bước: nên để mã chương trình tính
Phân loại email, tin nhắn, phản hồi khách hàngKiến thức sau thời điểm huấn luyện: mô hình không biết
Trả lời dựa trên tài liệu đưa kèmKết luận pháp lý, y tế: cần người có chuyên môn kiểm tra
Soạn nháp email, báo giá, mô tả sản phẩmThông tin nội bộ: mô hình không biết nếu không được cung cấp

Nhiều mô hình mới là đa phương thức: ngoài văn bản còn đọc được hình ảnh, tệp PDF, âm thanh. Điều này mở ra việc đọc hoá đơn chụp bằng điện thoại, chuyển ghi âm cuộc họp thành biên bản, hỏi đáp trên sơ đồ, bảng biểu.

Giới hạn quan trọng nhất cần nhớ: LLM không tra cứu sự thật, nó tạo ra văn bản có khả năng đúng cao nhất theo những gì đã học. Khi thiếu thông tin, nó vẫn có thể viết ra một câu trả lời trôi chảy nhưng sai. Vì vậy mọi hệ thống dùng LLM cho việc quan trọng cần nguồn dữ liệu đáng tin đưa kèm, đầu ra có kiểm tra, và người duyệt ở bước ảnh hưởng tới tiền hoặc khách hàng.

Chọn mô hình: API hay tự chạy

Hai cách dùng mô hình ngôn ngữ lớn
Tiêu chíDùng API (GPT, Claude, Gemini)Tự chạy mô hình mở (Llama, Qwen, Mistral)
Chất lượngThường cao nhất ở thời điểm phát hànhTốt với việc hẹp, kém hơn ở việc suy luận khó
Bắt đầuNhanh, chỉ cần khoá APICần máy chủ có GPU và người vận hành
Chi phíTheo lượng token sử dụngChi phí máy chủ cố định
Dữ liệuGửi tới nhà cung cấp, theo điều khoản của góiỞ lại trong hạ tầng của doanh nghiệp
Hợp vớiPhần lớn ứng dụng doanh nghiệpDữ liệu nhạy cảm, khối lượng lớn và ổn định

Giá API thay đổi thường xuyên theo từng phiên bản mô hình. Công cụ So sánh giá API LLM trong ALODEV Lab giúp ước tính chi phí theo số lượt gọi và độ dài văn bản trước khi chọn mô hình.

Thuật ngữ thường gặp khi làm với LLM

Mười thuật ngữ cơ bản về mô hình ngôn ngữ lớn
Thuật ngữNghĩa
TokenMảnh văn bản mô hình xử lý, thường là một phần của từ. Chi phí API và độ dài cửa sổ ngữ cảnh đều tính theo token
Prompt (câu lệnh)Văn bản gửi cho mô hình: chỉ dẫn, dữ liệu, câu hỏi
Tham sốCác con số bên trong mạng nơ ron, được điều chỉnh khi huấn luyện; số tham số nói lên quy mô mô hình
Cửa sổ ngữ cảnhLượng token tối đa mô hình xem được trong một lần gọi
EmbeddingVector biểu diễn ý nghĩa của một đoạn văn, dùng để tìm các đoạn văn có nghĩa gần nhau
Fine-tuningHuấn luyện thêm một mô hình có sẵn trên dữ liệu riêng để làm tốt một việc hẹp
RAGTìm tài liệu liên quan rồi đưa vào câu lệnh để mô hình trả lời dựa trên đó
Hallucination (bịa)Mô hình tạo ra thông tin nghe hợp lý nhưng sai
TemperatureMức ngẫu nhiên khi chọn token; thấp cho câu trả lời ổn định, cao cho văn bản sáng tạo
AgentHệ thống để LLM tự lên kế hoạch và gọi công cụ (tra cứu, tính toán, gửi email) qua nhiều bước

Ứng dụng LLM theo phòng ban

Mỗi ứng dụng đều có người kiểm tra ở bước ảnh hưởng tới tiền, khách hàng hoặc pháp lý
Phòng banViệc LLM hỗ trợNgười kiểm tra
Kế toánĐọc hoá đơn, chứng từ; đối chiếu với đơn mua hàng; phân loại chi phíKế toán viên duyệt trước khi ghi sổ
Chăm sóc khách hàngTrả lời câu hỏi thường gặp dựa trên tài liệu; tóm tắt lịch sử trao đổi; gợi ý câu trả lờiNhân viên duyệt câu trả lời nhạy cảm
Kinh doanhSoạn nháp email, báo giá; tóm tắt cuộc gọi; ghi thông tin khách vào CRMNhân viên kinh doanh chỉnh và gửi
Nhân sựSàng lọc sơ bộ hồ sơ theo tiêu chí; trả lời câu hỏi về quy chế nội bộChuyên viên nhân sự quyết định
Pháp chếTìm điều khoản trong hợp đồng, so sánh hai phiên bản, tóm tắt văn bản dàiNgười phụ trách pháp lý đọc lại nguồn
Ban giám đốcTóm tắt báo cáo, biên bản họp, danh sách việc cần làmNgười đọc đối chiếu với tài liệu gốc

Điểm chung của các ứng dụng hiệu quả: LLM không thay người ra quyết định mà làm phần đọc, tóm tắt, soạn nháp lặp đi lặp lại, để người làm phần cần phán đoán. Làm như vậy vừa giảm rủi ro khi mô hình sai, vừa dễ đo được giờ công tiết kiệm.

Các bước tích hợp LLM vào phần mềm doanh nghiệp

  1. Chọn một việc hẹp, lặp lại nhiều, có tiêu chí đúng sai rõ ràng: đọc hoá đơn, phân loại yêu cầu hỗ trợ, trả lời câu hỏi về quy trình.
  2. Gom dữ liệu mẫu thật và đáp án đúng để làm bộ kiểm thử.
  3. Chạy thử vài mô hình trên bộ kiểm thử, so chất lượng, tốc độ, chi phí.
  4. Thiết kế luồng có kiểm tra: đầu ra theo định dạng cố định, trường hợp không chắc chuyển cho người duyệt.
  5. Tích hợp vào phần mềm đang dùng, ghi nhật ký mọi lần gọi để theo dõi chi phí và lỗi.
  6. Chạy thử trên dữ liệu thật một thời gian, đo tỷ lệ đúng, rồi mới mở rộng.

Doanh nghiệp muốn đi sâu vào cách để LLM trả lời dựa trên tài liệu nội bộ có thể đọc thêm bài RAG là gì trên mục Tin tức của ALODEV.

Năng lực kỹ thuật

ALODEV bắt đầu từ một việc hẹp, có dữ liệu thật để đo, chạy thử rồi mới quyết định mở rộng. Hệ thống được thiết kế để vẫn vận hành khi dịch vụ AI chậm hoặc trả kết quả sai.

  • Tra cứu tăng cường (RAG)

    Chia nhỏ tài liệu, tạo vector nhúng, lưu bằng pgvector và kết hợp tìm theo từ khoá để lấy đúng đoạn liên quan.

  • Chọn mô hình theo việc

    Việc đơn giản dùng mô hình nhỏ, việc cần suy luận hoặc tài liệu dài dùng mô hình lớn hơn, cân đối giữa chất lượng và chi phí.

  • Đầu ra có cấu trúc

    Yêu cầu mô hình trả dữ liệu theo định dạng JSON cố định, kiểm tra lại trước khi ghi vào hệ thống.

  • Người duyệt ở bước quan trọng

    Kết quả liên quan tiền, hợp đồng, khách hàng được đưa vào hàng chờ duyệt thay vì ghi thẳng.

  • Bảo vệ dữ liệu

    Dùng gói dịch vụ doanh nghiệp không dùng dữ liệu để huấn luyện, che thông tin cá nhân trước khi gửi, hoặc chạy mô hình mở trên máy chủ riêng khi cần.

  • Kiểm soát chi phí

    Lưu đệm câu trả lời lặp lại, giới hạn độ dài đầu vào và theo dõi lượng sử dụng theo từng tính năng.

Nên dùng khi

  • Công việc lặp lại trên văn bản, giọng nói, hình ảnh: đọc chứng từ, phân loại, tóm tắt
  • Doanh nghiệp có kho tài liệu nội bộ mà nhân viên thường xuyên phải tra cứu
  • Có thể bố trí người kiểm tra kết quả ở các bước quan trọng

Không phù hợp khi

  • Việc giải quyết được bằng quy tắc cố định: viết quy tắc sẽ rẻ và ổn định hơn
  • Việc đòi hỏi kết quả đúng tuyệt đối mà không có người kiểm tra, như kết luận pháp lý, y tế
  • Dữ liệu không được phép rời khỏi hệ thống nội bộ mà chưa có hạ tầng chạy mô hình riêng

Công nghệ đi kèm

OpenAI APIAnthropic ClaudeGoogle GeminipgvectorWhisperVercel AI SDKLlama / Mistral

Câu hỏi thường gặp

Tất cả câu hỏi
Gửi dữ liệu doanh nghiệp cho OpenAI, Anthropic có an toàn không?

Các gói API và gói doanh nghiệp của OpenAI, Anthropic mặc định không dùng dữ liệu khách hàng để huấn luyện mô hình, chi tiết cần đọc theo điều khoản từng gói. Có thể che thông tin cá nhân trước khi gửi. Với dữ liệu đặc biệt nhạy cảm, có thể chạy mô hình mở như Llama, Mistral trên máy chủ riêng.

Nên chọn GPT, Claude hay Gemini?

Mỗi mô hình có điểm mạnh riêng và thay đổi theo từng phiên bản. Cách làm an toàn là chạy thử cả vài mô hình trên chính dữ liệu của doanh nghiệp rồi so sánh chất lượng và chi phí. Hệ thống nên được thiết kế để đổi mô hình mà không phải viết lại.

AI trả lời sai thì sao?

Mô hình ngôn ngữ có thể trả lời sai với giọng rất chắc chắn. Vì vậy câu trả lời nên kèm trích dẫn nguồn, dữ liệu trích xuất được kiểm tra định dạng, và các kết quả ảnh hưởng tới tiền hay khách hàng cần người duyệt. Tỷ lệ sai được theo dõi trên dữ liệu thật trong giai đoạn chạy thử.

Chạy thử một tính năng AI mất bao lâu?

Phụ thuộc vào độ sẵn sàng của dữ liệu và mức độ tích hợp với hệ thống hiện có. Nên chọn một việc hẹp, có tiêu chí đo rõ ràng, chạy thử trên dữ liệu thật rồi mới quyết định mở rộng. ALODEV ước lượng sau khi xem mẫu dữ liệu và quy trình hiện tại.

LLM là gì?

LLM (Large Language Model) là mô hình ngôn ngữ lớn, một loại mô hình trí tuệ nhân tạo được huấn luyện trên lượng dữ liệu văn bản khổng lồ để hiểu và tạo ra ngôn ngữ tự nhiên. GPT, Claude, Gemini, Llama là các LLM phổ biến.

LLM khác chatbot thế nào?

LLM là mô hình nền. Chatbot là một ứng dụng dùng LLM (hoặc dùng quy tắc cố định) để trò chuyện với người dùng. Cùng một LLM có thể dùng cho chatbot, đọc chứng từ, phân loại email hay tóm tắt tài liệu.

AI có thay thế nhân viên không?

Trong các ứng dụng doanh nghiệp phổ biến, AI đảm nhận phần việc lặp lại như đọc chứng từ, phân loại, soạn nháp. Nhân viên vẫn kiểm tra kết quả và xử lý các trường hợp phức tạp. Hiệu quả cụ thể cần được đo trên quy trình của từng doanh nghiệp.

Ước tính chi phí dự án

Cần tư vấn?